회사 밖으로 나가지 않는 AI
미발매 음원, 편집 전 촬영본, 다음 주 발표할 기획안. 이런 파일을 남의 서버에 못 올려서 AI 도입이 막히는 회사가 많다. 사내 컴퓨터 한 대에 올려 두고 쓰는 모델로 지금 무엇이 되고 무엇이 안 되는지 그리고 내년에는 어디까지 갈지 정리했다.
콘텐츠를 만드는 회사는 아직 공개하지 않은 파일 위에서 굴러간다. 미발매 음원, 편집 전 촬영본, 다음 주 발표할 기획안. AI 도구가 일을 줄여 주는 건 다들 아는데 이런 파일을 남의 서버에 올리기가 꺼려진다. 그래서 도입 회의가 늘 같은 자리에서 멈춘다.
지난 1년 사이 다른 길이 열렸다. 사내 컴퓨터 한 대에 모델을 올려 두고 쓰는 방식이다. 그 한 대로 지금 어디까지 되는지 아래에 정리했다.
공개 전이 가장 비싼 자산
이 문제는 업종을 가리지 않는다. 광고 대행사는 경쟁 PT 시안을 붙들고 게임사는 미발표 빌드와 아트를 붙든다. 웹툰 스튜디오는 원고를, 방송 제작사는 편집본을, 브랜드 인하우스팀은 신제품 캠페인 자료를 그렇게 붙든다.
값이 큰 이유는 공개 시점을 회사가 쥐고 있어서다. 컴백 곡이 발매 사흘 전에 인터넷에 풀리면 티저도 선주문도 음악방송 순서도 전부 헛돈다. 한 해 활동 계획이 통째로 틀어지는데 되돌릴 방법이 없다.
지금까지 그 걱정을 달래 준 건 약관이었다. 주요 업체가 입력 데이터를 학습에 쓰지 않겠다고 계약서에 적어 주는 것도 맞다. 그런데 실무자가 밤에 떠올리는 장면은 약관 위반이 아니다. 급한 담당자가 개인 계정에 올리고 외주 작업자가 자기 도구에 파일을 넣고 협업 툴 어딘가에 원본이 그대로 남는 장면이다.
약관은 회사와 업체 사이를 정리해 준다. 파일이 밖으로 나가는 것 자체를 막지는 못한다.
다만 여기까지만 이야기하면 절반을 놓친다. 실제로 사내에 두고 써 본 팀들은 보안 때문에 시작했다가 몇 달 뒤에는 다른 이유를 더 크게 친다. 돈이 덜 들고 손에 맞게 고쳐 쓴다는 쪽이다. 아래에서 셋을 다 본다.
일 년 사이에 바뀐 것
로컬 모델을 돌리자는 말은 오래된 이야기다. 다만 얼마 전까지는 권하기 어려웠다. 성능이 한참 처졌고 하드웨어가 비쌌고 무엇보다 손이 너무 많이 갔다.
지난 1년 사이 이 셋이 같이 풀렸다. 오픈웨이트 진영이 예상보다 빠르게 상용 시스템을 따라붙었고 수십억 달러를 들여야 만들던 모델을 이제 적당한 하드웨어를 갖춘 팀이면 내려받아 고쳐 쓰고 배포한다.
무엇보다 손이 덜 가게 됐다. Ollama 같은 도구를 쓰면 명령어 한 줄로 모델을 내려받고 실행한다. 양자화도 하드웨어 감지도 알아서 해 준다. 예전 같으면 엔지니어가 며칠 붙어야 했던 일이다.
보안만 보고 들어가면 절반만 얻는다
한 장 더 뽑는 데 돈이 안 든다
API를 쓰면 부를 때마다 돈을 낸다. 한두 건이면 신경 쓸 액수가 아닌데, 콘텐츠 만드는 조직의 일은 대개 건수로 쌓인다. 자막 초안 삼백 편, 썸네일 후보 이천 장, 촬영본 전사 백 시간, 스템 분리 오백 곡. 건당 몇십 원이 이 숫자를 만나면 달마다 나가는 고정비가 된다.
로컬에서는 GPU 값을 한 번 치르고 그다음부터 전기 요금만 낸다. 밤에 놀리는 시간에 배치를 걸어 둬도 청구서가 그대로다. 시안을 백 장 뽑든 천 장 뽑든 같다. 여기서 결과물이 달라진다. 열 장 안에서 골라야 하는 팀과 이백 장을 늘어놓고 고르는 팀은 다른 물건을 내놓는다.
손익분기는 정직하게 봐야 한다. 쓰는 양이 적으면 API가 싸다. GPU 값에 세팅하고 관리하는 사람 시간까지 얹으면 처음에 꽤 든다. 다만 같은 작업이 주마다 도는 조직이라면 몇 달 안에 그 지점을 넘긴다.
모델을 우리 손에 맞게 고친다
상용 API를 쓰면 모델 자체는 못 건드린다. 프롬프트로 구슬리는 게 전부다.
로컬에서는 다르다. 뒤에서 볼 ACE-Step은 여덟 곡을 넣고 RTX 3090에서 한 시간만 돌리면 자기 스타일을 모델 안에 넣어 준다. 이미지 쪽 LoRA는 이미 흔하다. 우리 아티스트의 얼굴, 우리 게임의 아트 톤, 우리 브랜드의 색을 미리 박아 두면 매번 프롬프트로 설명할 일이 없어진다.
버전을 붙잡아 둘 수 있다는 것도 크다. 상용 업체는 모델을 조용히 갈아 끼운다. 지난달에 통과한 프롬프트로 이번 달에 뽑으면 다른 그림이 나온다. 시즌 내내 톤을 맞춰야 하는 시리즈물에서는 이게 사고다. 받아 둔 가중치는 안 바뀐다.
검열을 안 받는다는 것도 실무에서는 의외로 크다. 상용 서비스는 안전 필터로 폭력 장면이나 공포물 콘셉트, 실존 인물이 얽힌 기획을 자주 막는다. 정당한 제작 업무인데 도구가 알아서 검열하고 되돌려보낸다. 로컬에서는 회사가 그 판단을 한다. 대신 그렇게 판단한 책임도 회사가 진다.
사소해 보이지만 현장에서 자주 걸리는 조건이 하나 더 있다. 인터넷이 없어도 돌아간다. 촬영장 컨테이너에서도 지방 편집실에서도 비행기 안에서도 같은 도구를 쓴다.
실무에 들어온 텍스트
네 영역 가운데 텍스트가 가장 앞서 있는데 이번 달에도 큰 물건이 하나 더 나왔다.
알리바바가 8월 3일 Qwen3.8 세대를 발표하면서 2.4조 파라미터 기함 Max와 27B 밀집형을 둘 다 오픈웨이트로 내겠다고 예고했다. Max를 8월 12일에, 27B를 8월 14일 저녁에 허깅페이스와 모델스코프에 올렸다. 27B에 Apache 2.0을 붙여서 매출 배분 조항 없이 상업적으로 쓸 수 있다. 별도 라이선스로 내놓은 Max와 다른 점이다.
알리바바 설명대로라면 27B는 소비자용 하드웨어에서 돌고 양자화하면 노트북에서도 뜬다. 그러면서 코딩과 실무, 리서치, 장기 에이전트 작업에서 열 배 큰 MoE인 Qwen3.7-plus와 맞먹는다고 한다. 이미지와 영상까지 읽는 네이티브 비전 언어 모델이기도 하다. 공개 이틀 만에 허깅페이스 최다 관심 모델 5위 안에 들었다.
사양을 정리하면 이렇다. 밀집형 27B에 텍스트와 이미지, 영상, 도표, 문서를 다 받는다. 네이티브 컨텍스트 26만 2천 토큰을 YaRN으로 100만까지 늘려 쓰고 사고 깊이를 조절해 연산을 아끼는 모드도 넣었다. 알리바바가 자체 평가로 내놓은 SWE-bench Pro 61.7은 전작 3.6-27B의 53.5를 넘었고 에이전트 터미널 코딩은 73.0 대 63.4다. 다만 독립 벤치마크가 아직 안 나와서 벤더 수치로 봐야 한다.
바로 앞 세대도 이미 인상적이었다. Qwen3.6-27B가 SWE-bench Verified에서 77.2%를 냈는데 두 달 앞서 나온 자사 397B MoE 기함을 소비자용 GPU 한 장에서 도는 27B가 앞질렀다. 알리바바는 한동안 Max급을 API 안에만 두다가 이번에 다시 열었다. 뒤에서 볼 영상 쪽과 정반대로 간다.
더 위를 보면 선택지가 있지만 회사 서버실에서 돌릴 이야기는 아니다. DeepSeek V4 Pro가 SWE-bench Verified 80.6%로 오픈웨이트 코딩 1위고 종합 지표에서는 Kimi K3가 57점으로 앞서고 GLM-5.2가 51점으로 뒤를 잇는다.
자체 호스팅이 되는지 따질 때 여기서 많이 헷갈린다. 활성 파라미터가 적으면 개인 PC에서 돌 것 같지만 아니다. Kimi K3는 활성이 104B인데 총 2.8조를 전부 메모리에 올려야 해서 4비트로 압축해도 594GB를 먹는다. 활성 파라미터는 속도를, 총 파라미터는 메모리를 정한다. 그러니 총 파라미터로 판단하면 된다.
GPU 등급으로 나누면 고르기가 쉬워진다. RTX 5080의 16GB에는 27B급이 4비트로 들어간다. 32GB인 RTX 5090은 Llama 4 Scout의 109B MoE를 오프로딩 없이 돌리는 유일한 소비자용 GPU다. 16GB 밑으로 내려가면 멀티모달 부담까지 계산해서 14B급이 사실상 천장이다.
| 메모리 | 돌릴 수 있는 크기 |
|---|---|
| 8GB | 8B 계열 |
| 16~24GB | 27B급, 실무 최적 지점 |
| 32GB 이상 | 활성 3B짜리 MoE까지 |
| 멀티 GPU 서버 | 200B급 |
| 데이터센터 | 700B급 |
실무로 옮기면 이런 일이 회사 안에서 돈다. 계약서와 정산 자료 요약, 미공개 기획안 검토, 사내 문서 검색, 고객 문의 1차 분류, 자막 초안, 보도자료 초고. 에이전트 리포트에서 다룬 반복 업무를 대부분 여기서 처리한다. 소비자용 GPU 한 장에 27B 안팎을 올려 두면 사내 문서 업무는 거의 다 소화한다.
사실상 따라잡은 이미지
플럭스 2와 Qwen-Image 같은 오픈웨이트 모델이 사실감과 글자 렌더링, 편집에서 폐쇄형 시스템과 같거나 앞선다. 배포와 데이터 취급을 전부 회사가 쥔 채로 그렇다. Qwen-Image는 200억 파라미터에 Apache 2.0이다.
올해 나온 것 중에서는 HiDream-O1-Image-Dev가 제일 흥미롭다. 80억 파라미터로 GenEval과 DPG, HPSv3에서 자기보다 일곱 배 큰 모델을 앞선다. VAE와 외부 텍스트 인코더를 통째로 걷어내고 2K를 네이티브로 뽑는 구조다. 5월 기준 Artificial Analysis 텍스트-이미지 아레나 8위에 올라 그 순위표의 오픈웨이트 중 가장 높았다. 28스텝에 CFG 없이 돌고 MIT 라이선스다. 이미지 안의 글자를 폐쇄형 상위 모델만큼 찍어 주는 오픈 모델을 기다렸다면 여기서 멈춰도 된다.
들어가는 돈도 내려갔다. Z-Image-Turbo는 16GB 안에서 8스텝으로 뽑고 플럭스 2 클라인 4B는 RTX 3090에서 13GB 정도만 쓴다. 둘 다 Apache 2.0이다. 이 둘 덕분에 자체 호스팅 진입선이 사람들이 이미 쓰고 있는 GPU 수준으로 내려왔다.
플럭스 2에 참조 이미지를 여러 장 넣으면 별도 학습이나 LoRA 없이 특정 인물이나 스타일, 제품을 붙여 준다. 얼굴 라이선싱 리포트에서 다룬 아이덴티티 고정을 로컬에서도 한다.
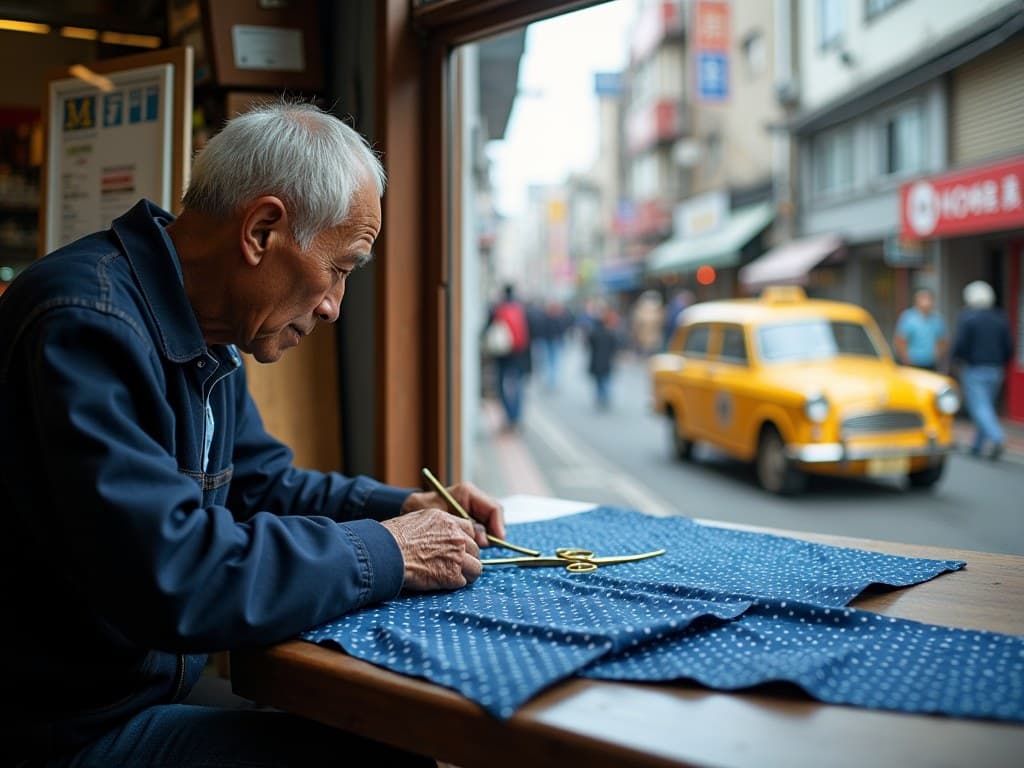
위 두 장은 누군가 개인 PC의 ComfyUI에서 FLUX.1 가중치로 뽑은 결과물이다. 클라우드를 거치지 않았고 프롬프트도 파일도 밖으로 나가지 않았다. 사진 Wikimedia Commons, 퍼블릭 도메인.
콘셉트 시안과 썸네일, 굿즈 목업, 무대 레퍼런스, 광고 러프 시안, 게임 아트 레퍼런스를 이렇게 회사 안에서 만든다.
다만 라이선스에 함정이 있다. 플럭스 2 클라인 4B는 Apache 2.0인데 9B는 아니다. 플럭스 2 dev도 오픈웨이트지만 상업적으로 쓰려면 블랙포레스트랩스 사이트에서 따로 신청해야 한다. 같은 이름을 달고도 조건이 다르다.
판이 뒤집힌 오디오
지난 1년 사이 가장 크게 뒤집힌 데가 여기인데 국내에서는 거의 다루지 않았다. 음성과 음악을 나눠서 봐야 한다.
음성
미스트랄이 3월 26일 내놓은 Voxtral TTS는 4B 오픈웨이트다. 블라인드 청취에서 62.8%가 일레븐랩스 Flash v2.5보다 낫다고 답했다. 3초짜리 오디오로 목소리를 복제하고 9개 언어를 지원하며 H200에서 첫 음성까지 70밀리초가 걸린다. 다만 CC BY-NC 4.0을 달아서 상업적으로 쓰려면 미스트랄 API를 거쳐야 한다.
라이선스가 자유로운 쪽도 있다. Step Audio EditX와 Fish Audio S2 Pro가 선두를 주고받고 Chatterbox는 MIT로 23개 언어를 처리하고 Kokoro는 8200만 파라미터로 CPU에서도 놀라운 소리를 낸다. 2년 전에는 어느 것도 내려받을 수 없었다.
IndexTTS2를 만든 팀은 감정 표현과 화자 정체성을 떼어 놓아서 음색과 감정을 따로 조절하고 음성 길이를 정확히 지정하게 했다. 자막 타이밍이 이미 정해진 더빙에서 크게 쓰인다.
가이드 보컬, 다국어 더빙 시안, 예고편 내레이션, 오디오북 초안, 사내 교육 영상 음성을 회사 안에서 만든다. 스템 분리와 전사, 노이즈 제거는 특화 모델이 오래전부터 소비자용 하드웨어에서 돌았다. 앞에서 말한 미발매 음원의 보컬 분리도 여기 해당한다. 그 작업은 지금 회사 안에서 된다.
음악
올해 오디오에서 제일 중요한 물건을 여기서 만들었다.
ACE Studio와 StepFun이 함께 만든 ACE-Step 1.5는 A100에서 한 곡에 2초, RTX 3090에서 10초 안에 뽑는데 4GB VRAM만 있으면 돌아간다. BPM과 키와 박자를 지정하고 참조 오디오로 스타일을 잡는다. 한국어를 포함해 50개 넘는 언어의 가사를 받는다. LoRA 개인화도 되는데 여덟 곡을 넣고 RTX 3090에서 한 시간 학습하면 자기 스타일이 모델에 들어간다. 12GB면 충분하다.
후속인 ACE-Step-1.5-xl은 디코더를 4B까지 키워 음질과 프롬프트 이해도를 올리면서도 증류 기술로 8스텝 만에 뽑는다. 그런데 정작 중요한 건 데이터 쪽이다. 저작권이 모호한 데이터로 학습해 실무에 쓰기 껄끄러웠던 기존 모델과 달리, 만든 쪽에서 정식 라이선스와 퍼블릭 도메인 데이터만 써서 결과물을 상업적으로 쓰도록 완전히 열어 놓았다.
이 조합을 한 번 짚어 볼 만하다. 깨끗한 학습 데이터, 상업 이용 허용, 4GB에서 도는 구동 환경, 그리고 로컬 실행. AI 표시 리포트에서 다룬 신고 의무와 겹쳐 보면 더 분명해진다. 학습 데이터 출처를 댈 수 있고 파일이 밖으로 안 나가는 구성이라면 발매물에 쓸 소재를 만들 때 지금 나온 선택지 중에 위험이 가장 적다.
절대 품질에서는 상용 서비스가 여전히 앞선다는 평가가 일반적이다. 그러니 발매곡을 여기서 뽑으라는 말로 읽으면 곤란하다. 다만 영상 배경음악과 예고편 트랙, 시안용 데모, 매장 음악은 다르다. 지금 외주를 주거나 라이브러리를 사서 쓰는 이런 작업을 회사 안에서 처리한다.
아티스트 목소리를 복제하는 작업이라면 기술보다 권리가 먼저다. 얼굴 라이선싱 리포트에서 다룬 그대로, 본인이 문서로 허락하지 않은 목소리는 로컬에서 돌린다고 안전해지지 않는다.
선택지는 넓고 천장은 낮은 영상
영상은 다른 세 영역과 사정이 조금 다르다. 쓸 만한 모델은 늘었는데 위쪽이 막혀 있다.
지금 실무에서 겨루는 이름은 넷이다. LTX-2.5와 Wan, HunyuanVideo, CogVideoX가 2026년 오픈 영상의 주력이다. 오픈웨이트 영상 모델이 폐쇄형 서비스 품질에 바짝 붙었고 LTX 계열만 허깅페이스에서 3300만 번 넘게 내려받았다. 연구용 호기심에서 제작 인프라로 넘어왔다는 신호다.
넷은 성격이 서로 다르다. LTX-2.5를 만든 팀은 품질보다 구조에 힘을 줬다. 영상과 오디오를 한 번의 순전파로 같이 만들고 컷을 넘어 연속성을 유지하는 다중 샷을 지원하고 깊이와 포즈와 엣지맵과 모션 트랙을 조건으로 받는다. 다른 모델로 하려면 별도 파이프라인을 붙여야 하는 기능이다. 텍스트와 이미지와 오디오에서 뽑고 기존 푸티지를 편집하고 조명을 바꾸고 대사를 갈아 끼우고 클립의 한 구간만 다시 뽑고 업스케일까지 모델을 바꾸지 않고 처리한다.
대신 문턱이 높다. 24GB 소비자용 GPU에서 Wan 2.1과 HunyuanVideo, CogVideoX, Mochi 1이 전부 도는데 LTX-2.5만 32GB를 요구해서 한 단계 위에 앉는다. 기능이 많은 대신 바닥이 높다는 정직한 맞교환이다.
GPU 용량별로는 이렇게 갈린다. 16에서 24GB 구간에서는 Wan 2.2의 작은 변형으로 480p를 뽑고 HunyuanVideo 1.5는 메모리를 끝까지 밀어내야 겨우 돈다. 24GB가 자체 호스팅 영상 작업의 권장 기준선인데 여기서 Wan 2.2가 720p로 돌고 HunyuanVideo 1.5가 480p를 75초쯤에 뽑는다. 48GB 이상으로 올라가면 고해상도와 배치 작업까지 열린다. 가장 낮은 바닥은 LTX 비디오의 8GB다.
위쪽이 막혔다는 건 이런 뜻이다. Wan 2.2가 여전히 마지막 오픈 Wan이다. 이후 2.5와 2.6과 2.7이 동기화된 오디오와 1080p와 세밀한 프레임 제어를 더했지만 전부 API 전용이고 가중치를 안 열었다. 그 위에 미니맥스 H3가 있다. 샷 설계와 캐릭터 일관성에서 앞서고 가중치도 열었는데 로컬로 돌리려면 80GB가 필요하다. MAGI-2도 24B 전체 변형에 48GB를 요구하고 8B 형제만 24GB에 들어간다.
최신 성과를 API 뒤로 감추기 시작한 쪽도 영상 개발사들이 먼저였다. 텍스트와 이미지와 오디오 쪽은 최신 모델을 계속 여는데 영상만 반대로 움직인다. 생성 비용이 크고 상용화가 빠른 탓으로 짐작한다.
그래서 프리비즈와 콘티, 내부 검토용 클립, 레퍼런스 영상은 회사 안에서 만들고 발매물 수준의 최종 결과물은 아직 상용에 맡긴다. 얼굴 라이선싱 리포트에서 다룬 시댄스급 모델을 로컬에서는 못 구한다. 미공개 소재가 들어가는 초기 단계를 로컬에서 돌리고 최종 렌더링은 공개해도 되는 시점이나 소재로 옮기는 편이 현실적이다.
성능보다 먼저 볼 라이선스
이 판에서 사고는 대개 여기서 난다.
실무자들은 라이선스와 관할을 먼저 정하고 작업 부하와 서빙 규모를 그다음에 보라고 조언한다. 오픈웨이트가 완전한 오픈소스를 뜻하는 경우는 드물다. 대부분 가중치만 열고 학습 데이터는 안 연다.
이름이 비슷해도 조건은 제각각이다. Apache 2.0과 MIT를 붙였으면 상업적으로 자유롭고 커뮤니티 라이선스에는 조건이 붙는다. 메타는 Llama 4로 서구권에서 생태계를 가장 넓게 깔았지만 커스텀 커뮤니티 라이선스를 쓰고 멀티모달 권리에서 유럽 개발자를 뺐다. 앞서 본 Voxtral처럼 성능이 좋아도 비상업 조건을 다는 경우도 있다. Kimi 계열이 내건 수정 MIT에는 대규모 서비스 시 표기 의무가 붙는다.
한국이 통째로 빠진 사례
국내 팀이 가장 크게 데일 조항은 허용 지역이다. 앞에서 본 미니맥스 H3가 그렇다. 미니맥스는 가중치에 라이선스를 붙이면서 허용 지역을 미국과 EU, 영국, 그리고 한국을 뺀 나머지 전 세계로 못 박았다. 한국에서 이 가중치를 받아 쓰려면 미니맥스에 따로 허가를 받아야 하고 그 전까지는 라이선스 밖이다.
미니맥스는 영상 생성 모델을 둘러싼 규제 환경을 이유로 들었다. 미국을 뺀 건 할리우드 스튜디오와 진행 중인 저작권 소송 때문이라고 이 회사 개발자 관계 총괄이 밝혔다. 국내에서 쓰려면 결국 미니맥스의 호스팅 서비스로 가야 한다.
가중치를 열었다는 말과 우리가 쓸 수 있다는 말이 같지 않다. 국내 팀은 성능 표를 펼치기 전에 허용 지역 조항부터 확인하는 편이 낫다.
라이선스와 별개로 관할도 봐야 한다. 중국 모델을 쓴다면 가중치를 받아 사내에서 돌릴 때와 그 회사의 호스팅 API를 쓸 때가 완전히 다른 판단이다. 후자에서는 데이터가 어느 나라 인프라를 지나느냐를 따져야 하고 개발사 중에는 미국 제재 목록에 오른 곳도 있다. 데이터 주권 때문에 시작한 일이라면 이 구분을 놓치면 안 된다.
호스팅에는 수명도 걸린다. 어떤 모델은 1월에 나와 5월에 문을 닫았고 다른 개발사도 구형 엔드포인트를 7월에 내렸다. 호스팅 API 위에 제품을 올리면 모델 수명 정책을 계속 확인해야 한다. 자체 호스팅에는 이 걱정이 없다. 받아 둔 가중치는 사라지지 않는다.
발매물에 쓸 결과물을 만드는 회사라면 라이선스를 취향 문제로 넘길 수 없다. 모델을 고르기 전에 계약서를 먼저 읽어야 한다.
내년에 무엇이 달라지나
지금 시점만 보고 판단하면 살 것도 안 사고 기다릴 것도 안 기다린다.
기다려도 안 오는 하드웨어
먼저 짚을 소식이 안 좋다.
엔비디아가 RTX 5060 Super 12GB, 5070 Super 18GB, 5080 Super 24GB 세 모델을 2027년 1월 CES에서 발표할 것으로 알려졌다. 5070 Super의 18GB는 소비자용 GPU에서 처음 나오는 용량이다. AI 작업을 개인 하드웨어에서 돌리려는 수요를 겨냥해 짠 라인업이다.
문제는 엔비디아가 이 제품들을 계속 미룬다는 점이다. 메모리 품귀로 2026년 상반기 GPU 생산을 30에서 40% 줄였고 그 여파로 Super 시리즈가 올해를 넘겼다. 특히 18GB와 24GB 모델을 가장 크게 미뤘다. 고밀도 3GB GDDR7 모듈이 필요한데 엔비디아가 그 물량을 마진 높은 데이터센터 부품에 먼저 쓰기 때문이다. 업계에서는 이 품귀가 2027년까지 이어진다고 본다. 일부 파트너에게는 무기한 연기라는 말까지 전했다고 한다. AMD도 차세대 아키텍처를 2027년 중후반 이후로 미뤄서, 엔비디아가 서둘러 내놓을 이유도 없다.
지금 24GB가 필요하면 중고 RTX 3090이나 신품 4090을 사면 된다. 기다리다가 1년 넘게 날릴 수 있고 소문난 사양이나 가격으로 나온다는 보장도 없다. 내년 CES를 기다려 18GB나 24GB를 사겠다는 계획은 위험하다. 반대로 지금 24GB 한 장을 확보해 두면 최소 1년은 값을 한다. GPU 값이 오르는 국면이라 늦게 살수록 비싸게 산다.
엔비디아 밖에도 길이 생겼다. 큰 모델을 올릴 때는 통합 메모리 기기를 쓸 만하다. 맥 스튜디오 M3 울트라는 최대 512GB 통합 메모리를 819GB/s 대역폭으로 쓴다. RTX 4090 네 장 이상이 필요한 모델을 올리면서 전력은 훨씬 적게 먹는다.
영역마다 다른 개방 속도
텍스트와 이미지와 음성은 지난 1년의 흐름을 이어갈 가능성이 크다. 27B급이 소비자용 GPU 한 장에 들어가는 구도가 자리를 잡았고 그 크기에서 성능이 계속 오른다. 하드웨어가 안 늘어나면 오히려 개발사들이 이 구간 최적화에 매달린다.
영상은 앞서 본 대로 반대다. 최신 성과를 API 뒤로 옮기는 흐름이 이미 시작됐고 뒤집힐 근거가 지금은 없다. 내년에도 로컬 영상은 프리비즈 도구로 남을 가능성이 높다.
그래서 지금 정할 것
하드웨어는 당분간 안 늘어난다. 그러니 24GB 한 장 안에서 돌아가는 구성을 설계 기준으로 잡는 게 맞다. 텍스트와 이미지와 음성은 그 안에서 실무를 돌리고 앞으로 더 좋아진다. 영상은 그 안에서 프리비즈까지만 하고 최종물은 밖에서 만든다.
내년에 하드웨어가 풀리면 그때 영상을 안으로 들이면 된다. 지금 없는 걸 기다리느라 시작을 미룰 이유가 없다.
정작 사고가 나는 자리
지금까지 클라우드와 로컬을 나눠 이야기했는데 실무에서 사고가 나는 자리는 그 구분 바깥에 있다.
직원이 개인 계정에 정산 파일을 올려 요약시킨다. 외주 편집자가 자기 도구에 원본을 넣는다. 홍보 담당자가 미공개 기획안을 챗봇에 붙여 넣는다. 이미 곳곳에서 벌어지는데 회사만 모른다.
여기에 로컬 환경의 진짜 쓸모가 있다. 못 쓰게 막는 대신 쓸 만한 걸 안에 두는 쪽이다. 사내에 쓸 만한 도구가 없으면 직원은 바깥 도구를 쓴다. 정책으로 막으면 숨어서 쓴다. 회사 안에 충분히 쓸 만한 환경을 깔아 주는 것이 유일하게 작동하는 통제다.
각자의 자리에서
경영진. 지금 회사에서 누가 어떤 파일을 어떤 도구에 넣고 있는지부터 파악해야 한다. 금지 공지를 돌리기 전에 실태를 봐야 한다. 그리고 24GB GPU 한 장 값은 신입 한 명 월급보다 싸고 앞으로 1년은 더 비싸질 가능성이 크다.
기술 담당자. Ollama나 LM Studio로 27B급을 띄우는 데 반나절이면 된다. 이미지는 ComfyUI가 표준이다. 먼저 한 대 세워 실무자에게 만지게 하는 편이 어떤 검토 문서보다 빠르다.
모델을 고를 때 벤치마크 순위표를 오래 들여다볼 필요는 없다. 벤더는 자기 모델에 유리한 설정에서 수치를 뽑고 벤치마크 문제가 학습 데이터에 섞였을 수도 있고 무엇보다 몇 달 늦게 현실을 반영한다. 그 대신 자사 업무 데이터로 스무 개에서 쉰 개쯤 사례를 만들어 직접 돌려 비교한다. 반나절이면 끝나고 벤치마크 백 개보다 정확하다.
실무자. 로컬에서 되는 일과 안 되는 일을 미리 구분해 두면 승인이 빨리 난다. 이 작업은 회사 안에서 됩니다, 하고 바로 답할 목록을 손에 쥐고 있으면 된다.
AI 서비스를 만드는 팀. 콘텐츠 조직을 상대하는 제품이라면 온프레미스 옵션을 기능 목록의 한 줄로 볼 수 없다. 그게 있어야 검토라도 받는다. 클라우드 전용으로는 이 판에서 가장 비싼 파일을 다루는 업무에 못 들어간다.
질문이 바뀌었다
일 년 전이었다면 이 글을 못 썼다. 로컬 모델은 데모용이었고 실무에 권하기 어려웠다.
지금은 다르다. 문서 업무와 이미지 작업과 음성 작업을 소비자용 GPU 한 장에서 돌리고 영상도 초기 단계까지 들어왔다.
한동안 써 본 팀들은 대개 처음 내세운 이유를 나중에 잘 얘기하지 않는다. 파일이 안 나가서 시작했다가, 시안을 천 장 뽑아도 요금이 안 붙는다는 것과 우리 아티스트 얼굴을 모델에 미리 넣어 둔다는 것을 더 자주 말한다.
그래서 물어야 할 것이 바뀌었다. AI를 쓸 것인가에서 어느 작업을 어디서 돌릴 것인가로 옮겨갔다. 그리고 회사가 답을 안 낸 곳에서도 직원들은 이미 답을 정해서 쓰고 있다.
함께 읽기
프롬프트 다음은 프리비즈
9월 첫 주에 세 가지가 연달아 나왔다. GPT-6 Astra가 블렌더에서 집을 짓고 언리얼로 옮겼고 힉스필드가 그 위에 3D 작업공간을 붙였고 Images 2.5가 참조 이미지 유지력을 끌어올렸다. 한 줄로 이으면 AI 영상을 만드는 순서가 바뀐다. 무엇이 확인됐고 무엇이 아직 벤더 주장인지 갈라서 정리했다.
AI 음악에 꼬리표가 붙는다. 그런데 답할 사람이 없다
세계 음반업계가 AI를 쓴 곡에 꼬리표를 붙이기로 하면서 음원 유통사 업로드 화면에 신고 칸이 생겼다. 마스터링을 웹 서비스에 맡겼는지 가사 초고를 챗봇으로 뽑았는지까지 묻는데 정작 그걸 기억하는 사람이 드물다. 국내 주요 음원 서비스 다섯 곳은 묻는 방식이 저마다 다르고 그중 셋은 아직 묻지도 않는다. 여기서 누른 값 하나가 어느 플랫폼까지 따라가는지 유통 경로를 되짚었다.

AI에게 우리 아티스트를 물어봤다
10개 팀에 네 가지를 묻고 네 조건에서 280건을 받아 사실과 대조했다. 오답률은 3.8%에서 40%까지 갈렸다. 가장 크게 벌어진 격차는 같은 모델 안에서 나왔다. 검색을 연결했느냐가 모델 선택보다 크게 작용했다.